最新发布第67页

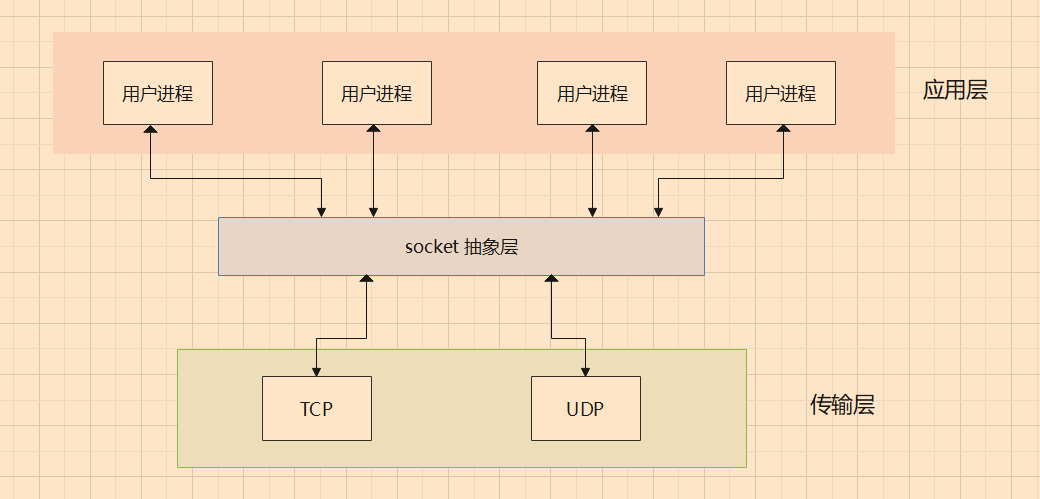
TCP/IP协议详解:探究互联网通信的基础架构与原理
TCP/IP协议是互联网通信的基石,它定义了计算机之间如何互联和通信的规则。 本文将详细介绍TCP/IP协议的基本概念、分层架构以及各层协议的作用和特点。 一、TCP/IP协议简介 TCP/IP,全称为传输...
 3年前

双活数据中心是什么? (双活数据中心有哪些优点)
双活数据中心是指在两个地理位置相距较远的地方建立至少两个数据中心,并在这些数据中心间运行实时应用程序。这种架构能够提高数据中心的可用性和灾难恢复能力,确保即使出现故障,也能保持应用...
3年前
Python自动化技术:构建自动阅读网页新闻的脚本
Python是一种非常适合网络爬虫和自动化任务的编程语言。 在本文中,我们将展示如何编写一个Python脚本来自动化阅读网页新闻。 爬虫的基本概念 网络爬虫是一种用来自动浏览World Wide Web的互联...
3年前
SFTP协议详解
SSH File Transfer Protocol(SFTP)是建立在SSH协议之上的安全文件传输协议。 相比于FTP和TFTP,SFTP提供了加密的通信通道,更适用于对安全性有较高要求的文件传输场景。 SFTP通过SSH协议进行...
2年前
MySQL连接上超时原因及解决方案有哪些?
MySQL连接上超时的常见原因主要有: 网络问题。比如网络不稳定, packets loss 丢包等情况。 数据库压力过大。CPU、内存等资源紧张,导致响应时间变长。 客户端连接参数设置错误。比如wait_timeout...
2年前
Python爬虫编程基础:从零开始学习网络数据抓取
什么是爬虫? 在计算机科学中,网络爬虫(又称为网页爬虫或者蜘蛛),是一种自动抓取网页内容的程序。 爬虫的主要作用是收集网页数据并将数据存储在本地或者数据库中。 Python爬虫的优势 Python...
3年前
nginx链接末尾自动补全斜杠(nginx详细教程)
如何在nginx链接末尾自动补全斜杠,下面不念就来讲一下详细步骤教程。 放在locaation里边就行 location /new { root /data/; index index.html; # 解决访问new 不加斜线时无法访问问题 if ( -d ...
3年前
java多态的表现形式有哪些?
Java 是一种面向对象的编程语言,它包含许多面向对象编程的重要特性,其中包括封装、继承和多态。 本文将重点介绍多态的各种表现形式,以及如何在Java中实现多态。 多态的定义 在 Java 中,多态...
3年前


标签云